Meta asegura que supera a competidores en determinadas pruebas
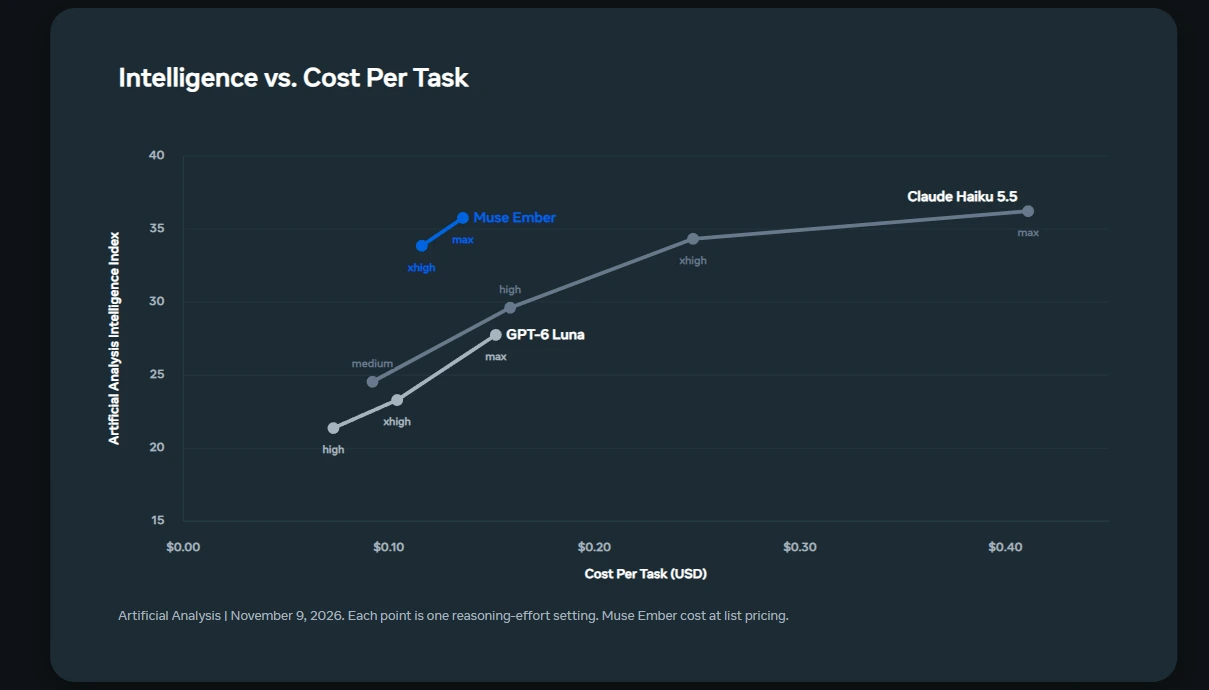
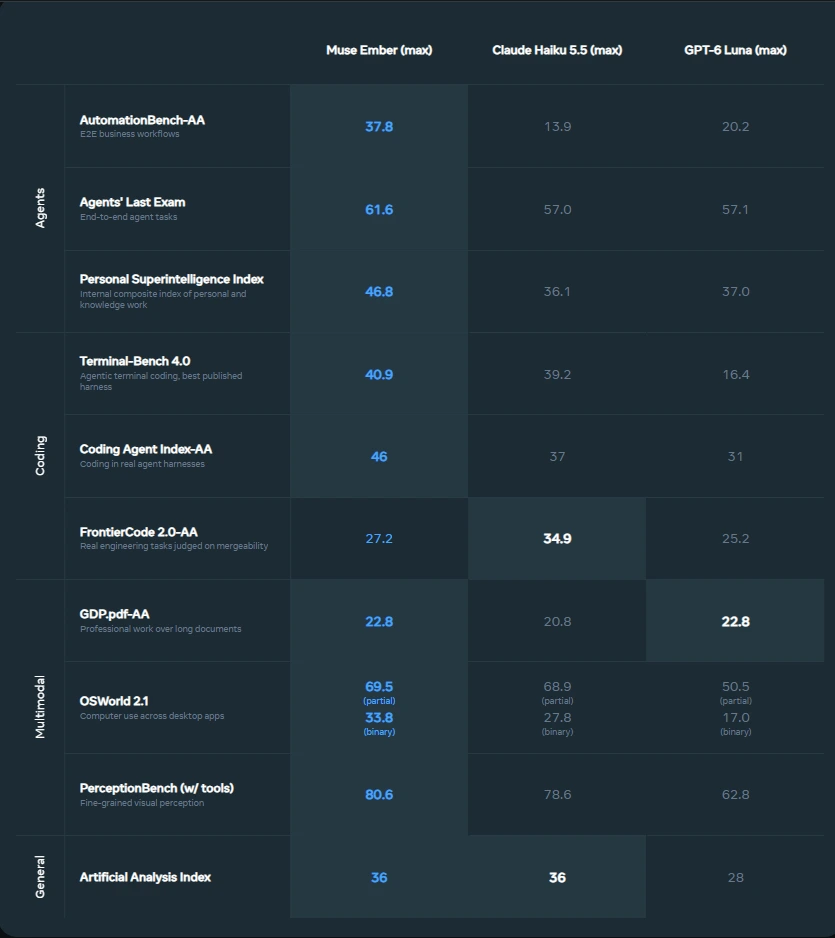
La empresa difundió resultados que comparan Muse Ember con Claude Haiku 5.5, de Anthropic, y GPT-6 Luna, de OpenAI.
En OSWorld 2.1, una prueba sobre el uso de computadoras, Ember obtuvo un 69,5% con evaluación de crédito parcial, frente al 68,9% de Haiku y el 50,5% de Luna.
En Terminal-Bench 4.0, orientada a tareas de programación, alcanzó 40,9 puntos, frente a 39,2 y 16,4, respectivamente.
No obstante, los resultados varían según la evaluación. En FrontierCode 2.0, Claude Haiku obtuvo una puntuación superior.
Estas comparaciones corresponden a configuraciones y pruebas específicas, por lo que no implican una superioridad general del modelo en todas las actividades.
Qué medidas de seguridad incorpora y dónde está disponible
Meta informó que Muse Ember fue evaluado frente a riesgos relacionados con ciberseguridad, materiales peligrosos y pérdida de control, y que permaneció por debajo de los umbrales de alto riesgo establecidos por la compañía.
También examinó su capacidad para respetar instrucciones, manejar información sensible y resistir órdenes maliciosas ocultas en documentos.
El modelo ya está disponible en Meta Model API y Muse Code, identificado como muse-ember-1.0.
Con esta incorporación, Meta busca que las tareas frecuentes de los agentes autónomos puedan ejecutarse a menor costo, mientras los sistemas más avanzados se concentran en resolver los problemas de mayor complejidad.